29-30 ოქტომბერს, თბილისში ალტე უნივერსიტეტისა და თბილისის სახელმწიფო უნივერსიტეტის ურთიერთთანამშრომლობითა და შოთა რუსთაველის საქართველოს ეროვნული სამეცნიერო ფონდის მხარდაჭერით გაიმართა კონფერენცია – „ხელოვნური ინტელექტი ჯანდაცვასა და მედიცინაში“ (AIMCare 2026).
საერთაშორისო ღონისძიებამ გააერთიანა დარგის ადგილობრივი და უცხოელი ექსპერტები და მოიცვა ისეთი მნიშვნელოვანი თემები, როგორიცაა AI-ს გამოყენება კლინიკურ დიაგნოსტიკასა და თერაპიულ ჩარევებში, სამედიცინო განათლებასა და პროფესიულ მომზადებაში, ადმინისტრირებასა და მართვაში.
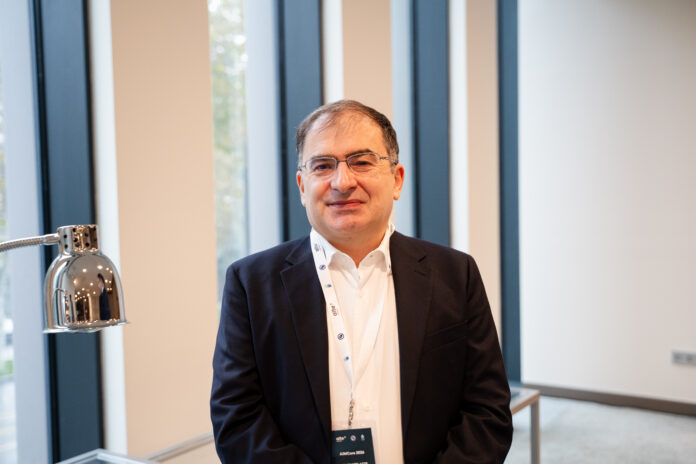
კონფერენციაზე პირველი ქართული სამედიცინო მეტყველების ამოცნობისა და ტექსტად გარდაქმნის – ენაგრამის სისტემა (Speech-to-text) წარადგინა მონაცემთა ანალიზის ლაბორატორიის დამფუძნებელმა, კავკასიის უნივერსიტეტის კომპიუტერული მეცნიერებებისა და ხელოვნური ინტელექტის პროგრამის ხელმძღვანელმა, პროფესორმა რატი სხირტლაძემ, რომელიც ახალი ტექნოლოგიის შესაძლებლობებსა და სამედიცინო სექტორში მის მნიშვნელობაზე გვესაუბრა.
ბატონო რატი, რა წარმოადგენს თქვენ მიერ შექმნილი პროდუქტი და რამ განაპირობა ჯანდაცვის სექტორში Speech-to-Text სისტემის დანერგვის საჭიროება?
ჩვენს პროდუქტს „ენაგრამის სამედიცინო საუბარმწერი“ ჰქვია. ინგლისურად Speech-to-text, თუმცა ქართულში მისი შესატყვისი ტერმინი ჯერ დამკვიდრებული არ არის. ჩვენ ვცდილობთ ტერმინად „საუბრის მწერი“ დავამკვიდროთ. ეს სისტემა ძირითადად ინგლისურზეა ადაპტირებული და ექიმებს მნიშვნელოვან დროს უზოგავს, რათა სამედიცინო ბიუროკრატიასა და ფორმების შევსებაზე ნაკლები დრო დახარჯონ.
2023 წელს ამერიკაში ჩატარდა კვლევა და აღმოჩნდა, რომ ექიმები კვირაში საშუალოდ დაახლოებით 15 საათსა და 30 წუთს ხარჯავენ ამ საქმეზე — სამედიცინო ფორმებსა თუ სხვა ბიუროკრატიულ სამუშაოზე. ამავე კვლევის ფარგლებში ნახეს, რომ ექიმები 4-5-ჯერ უფრო სწრაფად საუბრობენ, ვიდრე წერენ. შესაბამისად, ბუნებრივია, რომ ამ მიმართულებას ძალიან დიდი პოტენციალი აქვს და დასავლეთში — ამერიკის შეერთებულ შტატებსა თუ დასავლეთ ევროპაში — ეს პროდუქტები საკმაოდ განვითარებულია.
რა ტექნიკური თუ ენობრივი სირთულეები ახლდა თან ქართულენოვანი მოდელის შემუშავებას და რა ეტაპზეა პროექტი დღეს?
უკვე 23 წელია, რაც ქართული ენის მოდელირებას ვაკეთებთ. აქ უფრო რთულად გვაქვს საქმე, იმიტომ რომ ქართული არის აგლუტინაციური ენა, რაც ნიშნავს, რომ სიტყვა შედგება მორფემებისგან — ნაწილებისგან. მაგალითად, ინგლისურ ზმნაში თუ გვაქვს 5 ფორმა, ქართულ ზმნას გაცილებით მეტი ფორმა აქვს და ყველა ეს ფორმა უნდა იცნოს სისტემამ.
გამოწვევების მიუხედავად, ჩვენ მაინც შევეჭიდეთ ამ საქმეს: 200-ზე მეტი ექიმი და სამედიცინო სტუდენტი ჩავწერეთ, წავაკითხეთ 100-ზე მეტი სამედიცინო ტექსტი, სახელმძღვანელოები, ფორმა 100-ები, წამლების ინსტრუქციები და ძალიან დიდი ენერგიის ფასად გავწვრთენით ქართული სისტემა. ის არის გაცილებით ზუსტი, ვიდრე ნებისმიერი სხვა Speech-to-text-ი კონკრეტულად სამედიცინო ტერმინოლოგიისა და ტექსტებისთვის — დაახლოებით 5-ჯერ ნაკლებ შეცდომას უშვებს, ვიდრე ყველაზე საუკეთესო, ვთქვათ Amazon-ის ქართული Speech-to-text-ი.
კონკრეტულად რომელ მოდელს დაეყრდენით მისი შექმნისას?
Wav2Vec 2.0 (Wave to Vectors 2.0) არის ის Speech-to-text-ის სისტემა, რომელიც ჩვენ გადავწვრთენით ჩვენს მონაცემებზე. მივიღეთ ძალიან მაღალი სიზუსტე, მაგრამ ამას კიდევ სჭირდება დამუშავება. როგორც აღვნიშნე, უკვე 23 წელია ქართული ენის მოდელირებას ვაკეთებთ და ეს მეორე ნაწილი (ენობრივი დამუშავება/სწორება) უკვე ჩვენი ტრადიციული მეთოდებით გავაკეთეთ.
სამედიცინო მონაცემების უსაფრთხოება და კონფიდენციალურობა კლინიკებისთვის უმთავრესი პრიორიტეტია. ამ მხრივ, რამდენად დაცულია პაციენტის მონაცემები თქვენი სისტემის გამოყენებისას?
სამედიცინო მონაცემების უსაფრთხოება კლინიკებისთვის, სრულიად მართებულად, უმთავრესი პრიორიტეტია, რათა ეს ინფორმაცია საიმედოდ იყოს დაცული და არ აღმოჩნდეს მესამე პირის ხელში. ჩვენი ეს სისტემა საქართველოშია შექმნილი და შესაძლებელია მისი სრულად დაინსტალირება უშუალოდ კლინიკის სერვერზე. ეს მონაცემი გარანტირებულად არასდროს არ დატოვებს ამ კლინიკის ტერიტორიას. მაშინ, როცა საერთაშორისო Speech-to-text-ის (Microsoft-ის, Amazon-ის თუ ნებისმიერი სხვა სისტემის) გამოყენებისას, ის აუცილებლად ტოვებს ქვეყნის საზღვრებს. მონაცემთა დაცვის კუთხით, ეს სისტემა სრულად უნიკალურია.
როგორ უნდა დავიცვათ თავი უზუსტობებისგან?
საბოლოო ჯამში პასუხისმგებელი მაინც ექიმია. ხელოვნურ ინტელექტს ვერაფერს ვერ გადავაბრალებთ, ის მხოლოდ მნიშვნელოვნად ამარტივებს ჩვენს საქმეს — შეიძლება დროის 80% დაზოგოს, მაგრამ საბოლოო პასუხისმგებლობა მაინც ადამიანზეა. ექიმმა ყველა ტერმინი, რასაკვირველია, უნდა გადაამოწმოს.
ახლა ეს ყველაფერი გავაკეთეთ ლაბორატორიულად, ჩვენს ლაბორატორიაში, და ჩვენი მიზანია, რომ კლინიკებს შევთავაზოთ, დაიწყონ სატესტო რეჟიმში მისი დანერგვა. დანერგვის პროცესში, როდესაც ახალი ხმოვანი მასალა დაემატება, ჩვენ კიდევ უფრო გავზრდით ამ სიზუსტეს და ეს მუდმივი პროცესი იქნება.